把 MySQL 的订单表同步到另一个库,第一次要搬历史数据,后面还要处理新订单、支付状态变化和删除记录。看起来都是“数据库同步”,选择的任务方式却会直接影响哪些变化能够被采集。
DataMover 提供可视化的异构数据源迁移、同步与集成。本篇先用 MySQL 作为源端和目的端,把普通任务和实时任务各走一遍:既看页面如何配置,也到目标库确认数据是否真的到达。
社区版永久免费,支持最多 70 张表并发调度:两个普通任务各支持 10 张表,一个实时任务支持 50 张表。可以从 官网下载页 获取安装包,用自己的测试库复现本文流程。
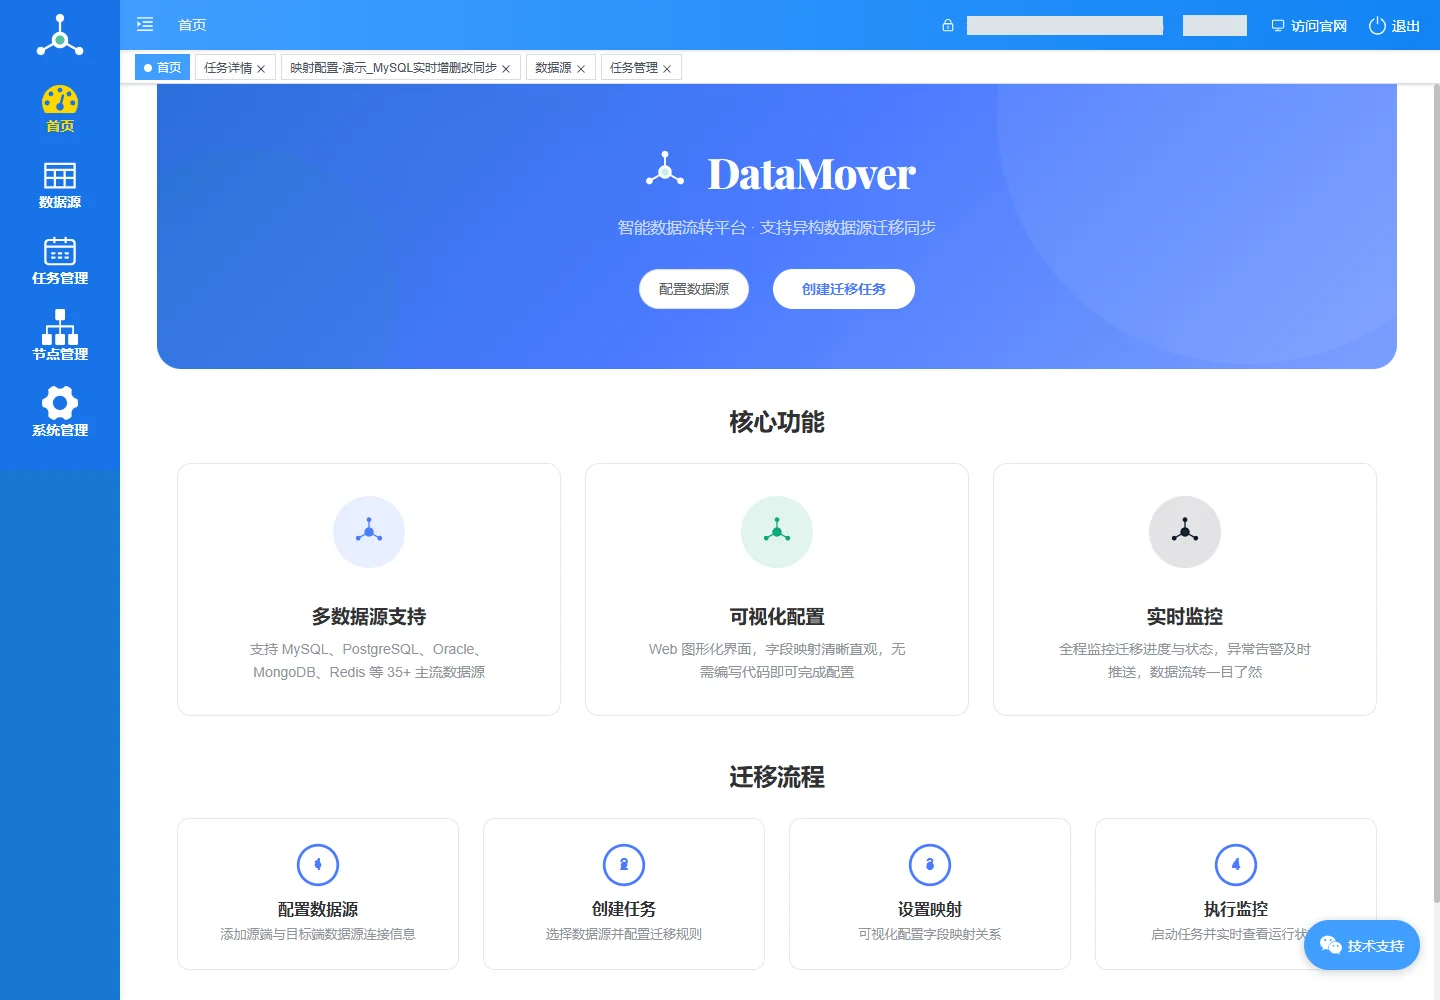
登录后的系统首页集中展示了数据源配置、任务创建和操作流程。接下来就从这些入口完成 MySQL 到 MySQL 同步。
先分清三种同步方式
本次使用两张同结构的订单表,分别演示两条任务,避免它们同时写同一张目标表。
| 方式 | 本次怎么配置 | 实际要解决的问题 |
|---|---|---|
| 普通全量 | 读取整张 orders_batch,一次性执行 | 把已有的 3 条订单复制到目标库 |
| 普通字段增量 | 沿用这条普通任务,按 order_id 继续读取 | 已复制到 1003 后,补入新订单 1004 |
| CDC 实时任务 | 独立订阅 orders_cdc,首次快照后持续读 binlog | 同步新增订单、金额和状态更新、物理删除 |
普通任务写入数据库时,可以根据键实现 存在则更新、不存在则插入。本例用 order_id 主键定位目标记录;增量字段决定“读哪些记录”,目标端的键决定“更新哪条记录”,两者承担不同作用。
通常建议使用更新时间字段作为增量字段,前提是业务在新增、修改时都可靠维护该字段,并合理设置时间精度与读取边界。这样原订单的金额、状态变化也有机会被再次读取,再按键更新到目标。自增 ID 适合追加数据,本篇先用它演示最容易观察的“只补新订单”。
普通任务的局限是 不支持同步源端的物理删除:记录被删除后,字段增量查询就读不到它,也不会自动向目标发出删除操作。需要持续传递新增、修改和删除时,应使用 CDC。
目的端只能是 MySQL 吗?
MySQL 是本次实际验证的目的端,DataMover 的写入范围还包括其他数据库和数据系统。普通任务与 CDC 的目的端能力需要分别看:
| 任务方式 | 目的端支持情况 | 选择时看什么 |
|---|---|---|
| 普通任务 | 可写 MySQL、PostgreSQL、Oracle、SQL Server、达梦、Kingbase 等数据库,也有 ClickHouse、Doris、Hive、MongoDB、Kafka 及文件类连接器的写入能力 | 对照连接器的 writer(写) 能力,确认字段类型与目标写入规则 |
| CDC 实时任务 | 本次演示版本的实时数据库目的端范围包括 MySQL、MariaDB、PostgreSQL、Oracle、SQL Server、达梦、Kingbase、GaussDB、Citus、TiDB、PolarDB MySQL、OceanBase MySQL;另外包括 Doris、SelectDB、Elasticsearch | 确认 CDC writer,目标还要能按其写入语义处理变更;不能把普通写入支持直接当成 CDC 支持 |
需要 CDC → Kafka 时,应使用已经提供该能力的版本,并配置 Topic 和消息格式;这与普通任务把查询结果写入 MQ 是不同的链路,本文验证的是数据库目的端。安装版本和连接器能力可以对照 数据源链路文档,再以部署版本的实时任务可选目的端为准。
目的端支持也不代表所有组合具有相同的数据类型和 DDL 行为。将本例目标改成 PostgreSQL、Oracle 或达梦时,仍要检查主键、字段映射和写入方式;实时任务按同一种目的端类型组织,数据库与 MQ 分开建任务。
准备两个演示库和订单表
如果尚未部署 DataMover,推荐先使用 Docker 一键安装。准备好 Docker 环境,在 Linux 或 macOS 的终端执行官网提供的命令:
bash -c "$(curl -fsSL https://down.datamover.cn/install.sh)"
脚本自动完成下载、解压和部署。Windows 的 PowerShell 入口及详细配置见 官网 Docker 一键安装区 和 Docker 部署文档,启动后按安装输出的地址进入管理页面。
如果希望直接在主机上部署,也可以从 官网下载页 获取安装包,按 Linux 安装文档 或 Windows 安装文档 配置并启动。
本次直接使用已部署的实例;数据库为 MySQL 8.0.25,两个库位于同一实例,也可以分别放在两台 MySQL 上。
| 角色 | 库 | 表 |
|---|---|---|
| 源端 | dm_demo_source | orders_batch、orders_cdc |
| 目的端 | dm_demo_target | 同步时创建同名目标表 |
在源库创建表并插入初始数据:
CREATE DATABASE dm_demo_source CHARACTER SET utf8mb4;
CREATE DATABASE dm_demo_target CHARACTER SET utf8mb4;

CREATE TABLE dm_demo_source.orders_batch (
  order_id      BIGINT       NOT NULL PRIMARY KEY,
  customer_name VARCHAR(40)  NOT NULL,
  amount        DECIMAL(12,2) NOT NULL,
  status        VARCHAR(16)  NOT NULL,
  updated_at    DATETIME     NOT NULL
) ENGINE=InnoDB;

INSERT INTO dm_demo_source.orders_batch VALUES
(1001, '杭州门店', 199.90, 'PAID', '2026-11-12 09:00:00'),
(1002, '宁波门店',  89.50, 'NEW',  '2026-11-12 09:05:00'),
(1003, '温州门店', 360.00, 'PAID', '2026-11-12 09:10:00');

CREATE TABLE dm_demo_source.orders_cdc
LIKE dm_demo_source.orders_batch;

INSERT INTO dm_demo_source.orders_cdc
SELECT * FROM dm_demo_source.orders_batch;
保留这五个字段就足够看清关键行为:order_id 用来定位记录,DECIMAL(12,2) 检查金额,中文名称检查字符内容,status 展示业务状态变化,updated_at 记录本次修改时间。目标库先保持为空。
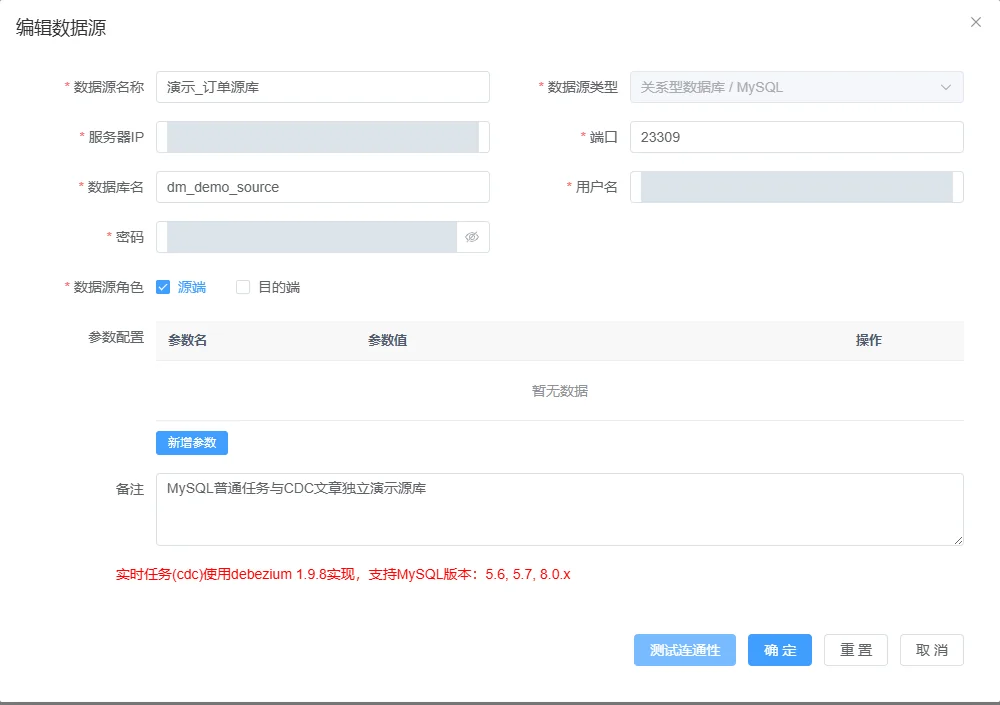
进入“数据源 → 新增”,建立两个 MySQL 连接:
- 演示_订单源库:数据库填
dm_demo_source,角色勾选“源端”。 - 演示_订单目标库:数据库填
dm_demo_target,角色勾选“目的端”。
分别填写自己的连接地址、端口和账号,点击“测试连通性”通过后保存。Worker 必须能访问这两个地址;容器中配置的 localhost 指向容器自身。
普通任务:先把 3 条历史订单同步过去
选择数据源与映射
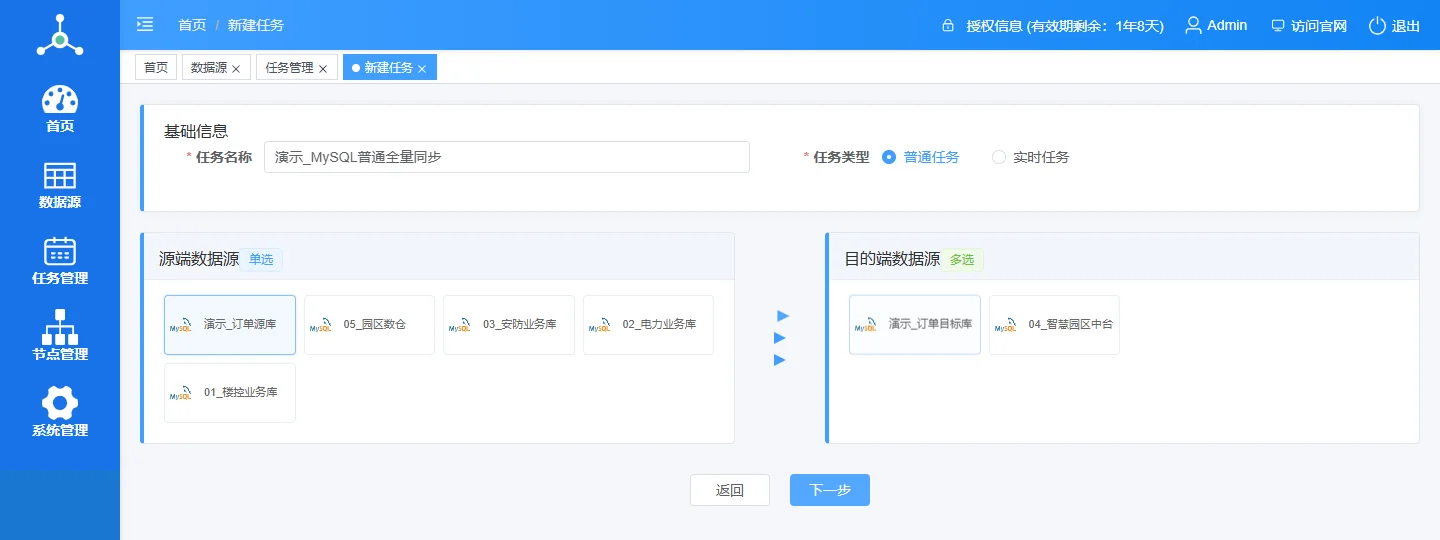
进入“任务管理 → 新建任务”,任务名称填“演示_MySQL普通全量同步”,类型选择“普通任务”,左侧选择演示源库,右侧选择演示目标库,然后进入下一步。
在“源端数据”旁点击 +(选择数据集),展开 dm_demo_source,勾选 orders_batch 并确认。刚进入配置页时没有表,需要先完成这一步。
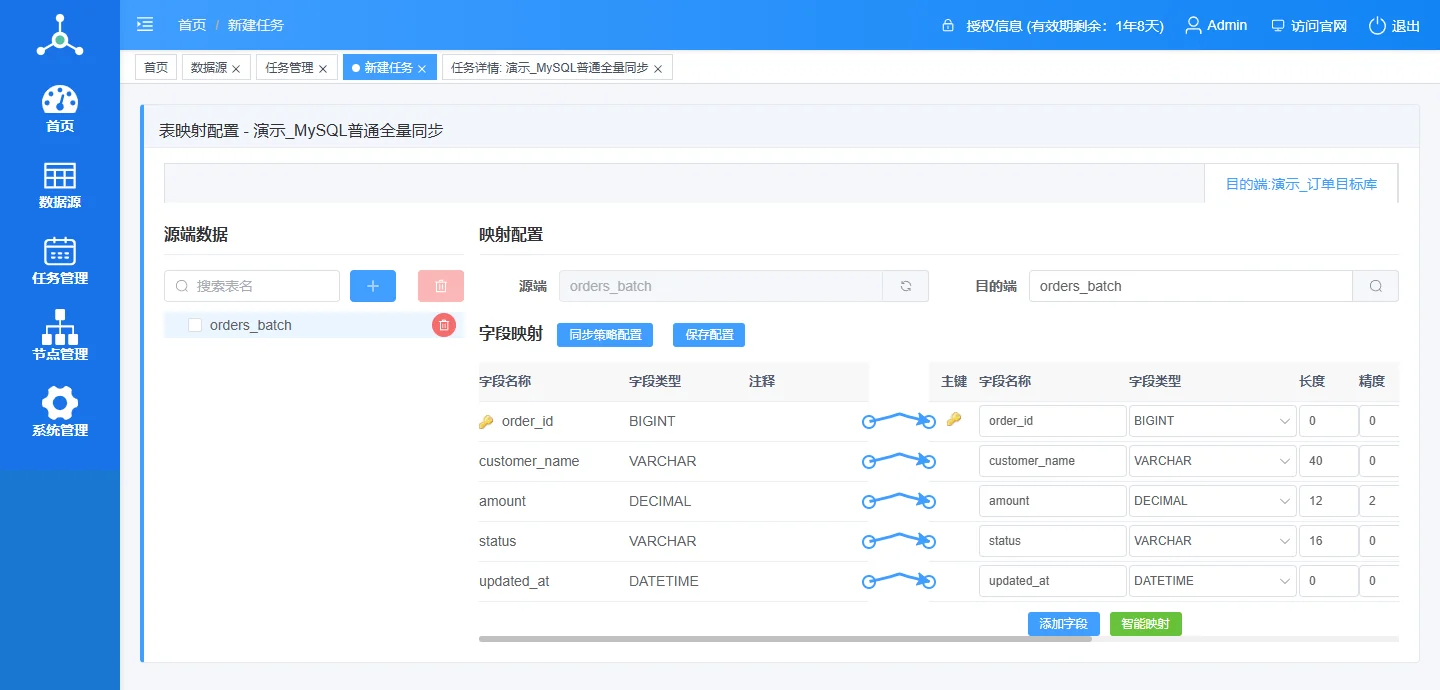
选择源表后,检查映射中的目标表名仍是 orders_batch,并确认:
order_id仍为主键,目标类型为BIGINT。customer_name的长度为 40,status的长度为 16。amount保留DECIMAL的长度 12、精度 2。updated_at映射为DATETIME。
本次保留同名字段,不添加转换函数。目标表原先不存在,启动时按保存的映射创建。
目的端的写入按键匹配:order_id 已存在时更新对应记录,不存在时插入。本例使用的 MySQL 写入方式会利用主键或唯一键识别已有记录,因此要保留正确的主键映射,不能只配置一个普通字段就期望它自动承担匹配键作用。下面全量阶段先清空目标,看到的是三条初始记录写入;这种写入规则同样服务于后续增量读取到的记录。
配置一次性全量
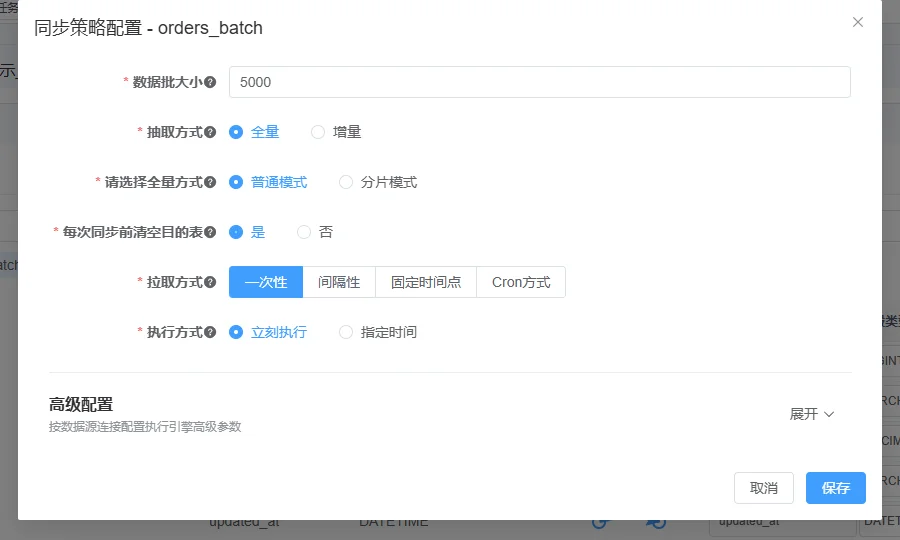
点击“同步策略配置”,本次选择:
| 配置项 | 本次取值 | 为什么这样配 |
|---|---|---|
| 抽取方式 | 全量 → 普通模式 | 读取整张小表 |
| 每次同步前清空目的表 | 是 | 目标是独立演示表,结果应与这次全量一致 |
| 拉取方式 | 一次性 | 本轮完成后结束,不持续调度 |
| 执行方式 | 立刻执行 | 启动任务后立即进行本轮同步 |
| 数据批大小 | 5000 | 保持默认配置,本次不做吞吐调优 |
“清空目的表”影响的是目标数据,不能直接照搬到需要保留原有数据的目标表。
保存同步策略,再点击“保存配置 → 完成”。在任务详情点“全部启动”,选择执行节点并确认。本次节点显示为 worker:8011,实际环境选择自己的在线节点。
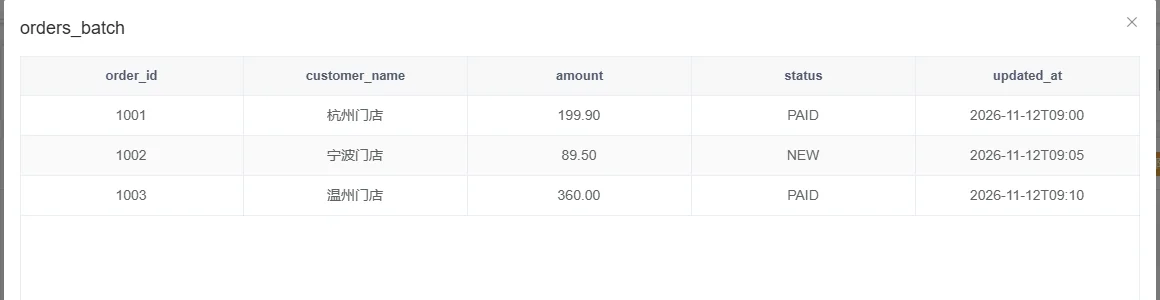
任务完成后,界面显示 采集 3 行、输出 3 行、失败 0 行。再点目标表名查看数据,并用数据库查询核对:
SELECT order_id, customer_name, amount, status, updated_at
FROM dm_demo_target.orders_batch
ORDER BY order_id;
结果为 1001、1002、1003 三条记录,金额分别是 199.90、89.50、360.00,中文名称和时间与源端一致。
普通增量:历史数据保留,只补新订单
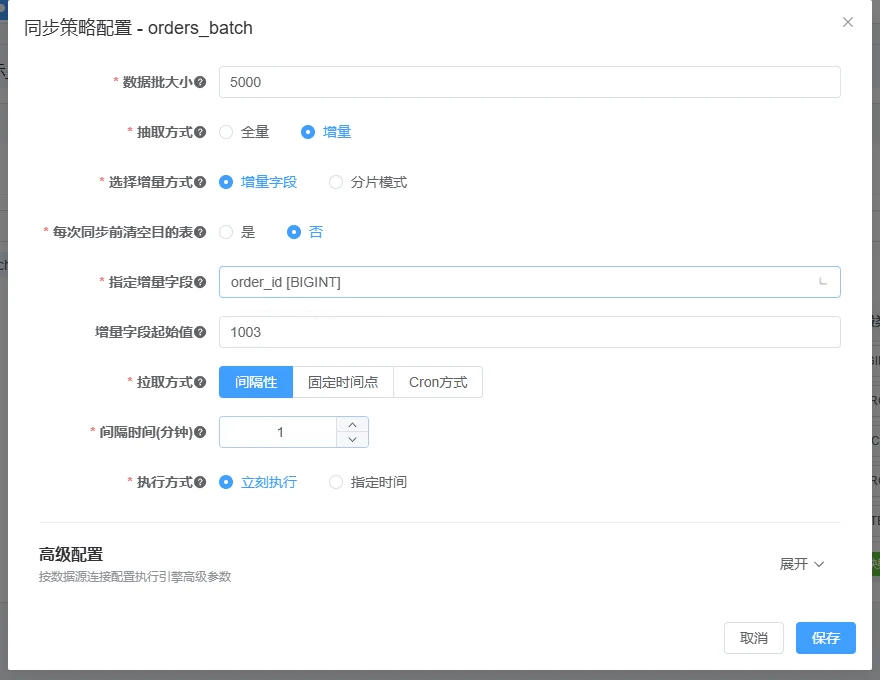
全量完成后,这张演示表的最大订单 ID 是 1003。回到“配置任务 → 同步策略配置”,将普通任务改成:
- 抽取方式:增量 → 增量字段。
- 指定增量字段:order_id,起始值填 1003。
- 每次同步前清空目的表:否,保留刚才的三条历史记录。
- 拉取方式:间隔性,间隔时间 1 分钟;执行方式仍为“立刻执行”。
这里的单位是分钟。1 分钟用于演示定期查询,不是 CDC 的采集间隔。
保存后,在源库新增一条订单:
INSERT INTO dm_demo_source.orders_batch VALUES
(1004, 'Nanjing Store', 129.00, 'NEW', '2026-11-12 10:00:00');
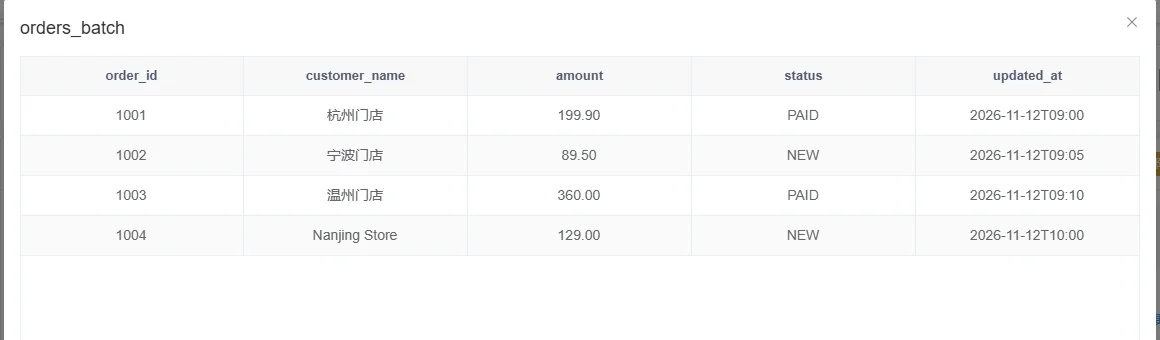
再次“全部启动”。本次启动后的首轮补入 1 行,目标表保留原有三条记录并增加 1004,总计 4 行。界面中“调度中”表示任务还会按间隔继续运行,不是卡在未完成状态;每一轮的数据结果可以结合采集、输出行数和目标查询判断。
这个配置适合 ID 持续递增的追加场景。如果把 1002 的状态从 NEW 改为 PAID,ID 没有增长,这条按 ID 查询的任务不会再次读到它。业务有更新需求时,建议改用可靠维护的 updated_at 作为增量字段:源端新增、修改都刷新它,符合增量条件的记录会再次读取,并根据目标端的键更新已有订单。增量字段不必和目标匹配键相同。
即使用更新时间作为增量字段,物理删除也不会自动同步到目标。下面用 CDC 直接捕获这两类变化。
本次普通增量验证结束后点击“全部停止”,保留任务和数据,接着演示另一张表。
实时任务:首次快照后持续同步增删改
先确认 MySQL CDC 条件
MySQL 作为实时任务的源端,需要开启 binlog,并为同步账号配置读取和复制权限。目标端虽然也是 MySQL,但作为本条链路的写入端,不需要为了接收数据再配置一条反向 CDC。
按 CDC 实时同步必读 检查源库,查询当前生效值:
SELECT VERSION() AS mysql_version,
       @@log_bin AS log_bin,
       @@binlog_format AS binlog_format,
       @@binlog_row_image AS binlog_row_image,
       @@server_id AS server_id;
本次结果为 8.0.25 / 1 / ROW / FULL / 1。普通连接测试通过只说明能连上,CDC 还需要这些日志条件与相应权限。
建立独立的实时任务
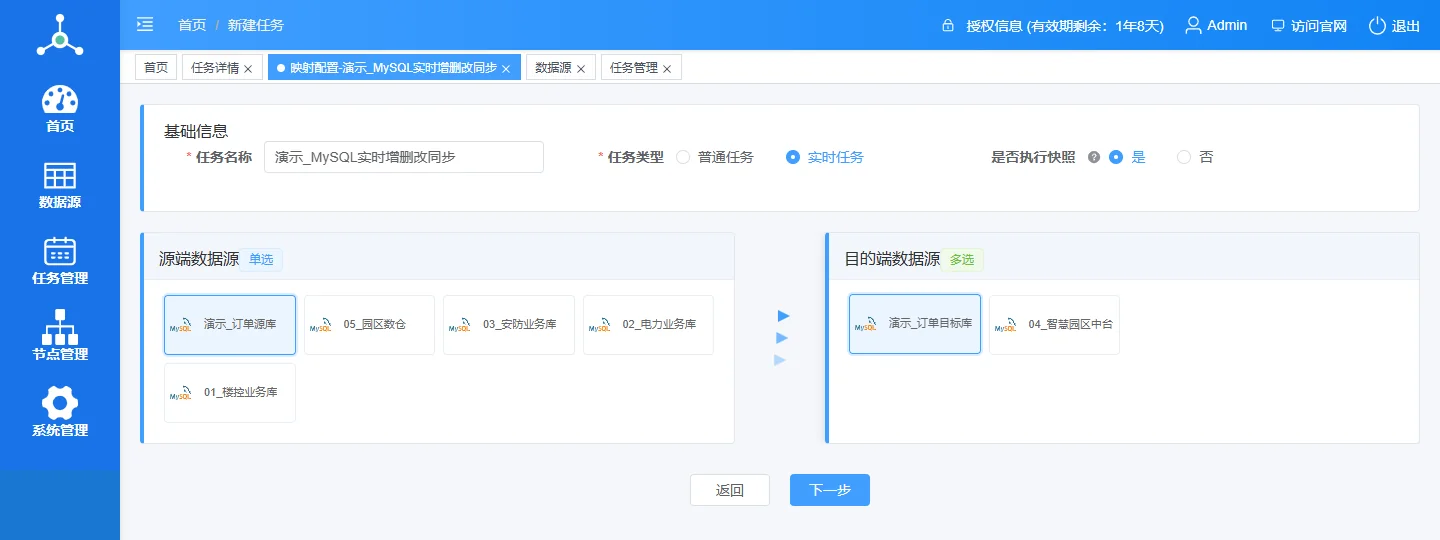
新建“演示_MySQL实时增删改同步”,类型选“实时任务”,“是否执行快照”选 是。源端和目的端仍使用刚才的两个 MySQL 连接,这次只勾选 orders_cdc,映射到目标库的同名表。
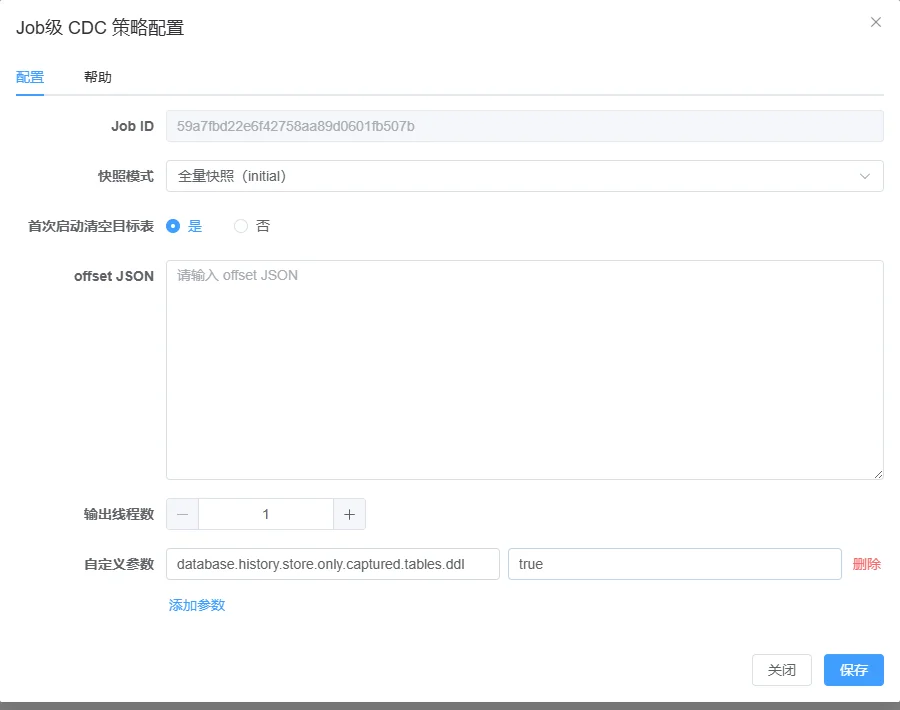
检查字段和主键映射,保存并完成。在任务详情打开 CDC策略配置:
| 配置项 | 本次选择 | 含义 |
|---|---|---|
| 快照模式 | 全量快照 initial | 首次建立同步状态时先读取现有记录,再持续读取日志变更 |
| 首次启动清空目标表 | 是 | 本次目标是独立演示表,以源表存量初始化 |
| offset JSON | 留空 | 新任务由连接器建立初始位点,不手工填写历史位置 |
| 输出线程数 | 1 | 本次小表保持默认 |
| 自定义参数 | database.history.store.only.captured.tables.ddl=true | 历史结构记录聚焦订阅表,适合本次固定订阅范围 |
自定义参数不是增删改开关,也不代表目标端自动执行所有 DDL。后续扩大订阅范围时,需要单独核对新增表的结构历史和初始化方式。
保存并“全部启动”。首次快照完成后,目标 orders_cdc 中出现初始的 1001、1002、1003。此时实时任务继续运行,等待后续变更;它不会像一次性普通任务那样读完后结束。
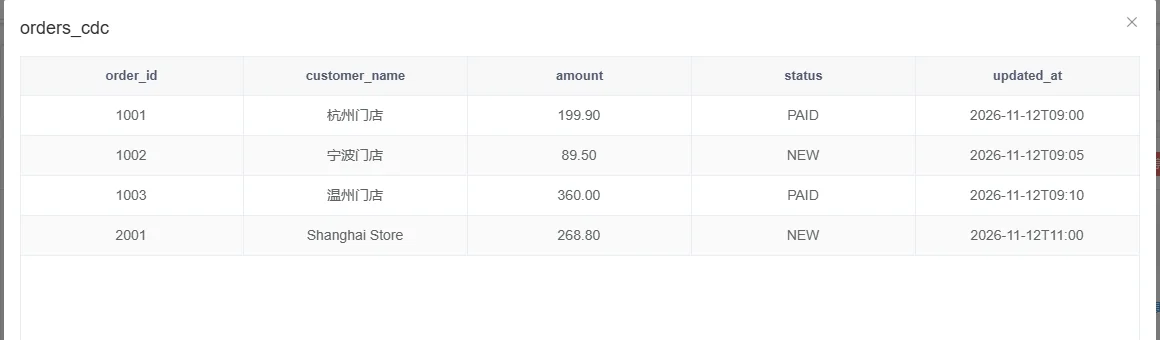
新增订单:目标出现 2001
在源库执行:
INSERT INTO dm_demo_source.orders_cdc VALUES
(2001, 'Shanghai Store', 268.80, 'NEW', '2026-11-12 11:00:00');
源端提交后,目标库出现订单 2001,金额 268.80、状态 NEW。查询和预览都能看到它:
更新已有订单:金额与状态一起变化
接着修改同一个主键,不新增记录:
UPDATE dm_demo_source.orders_cdc
SET amount = 299.90,
    status = 'PAID',
    updated_at = '2026-11-12 11:10:00'
WHERE order_id = 2001;
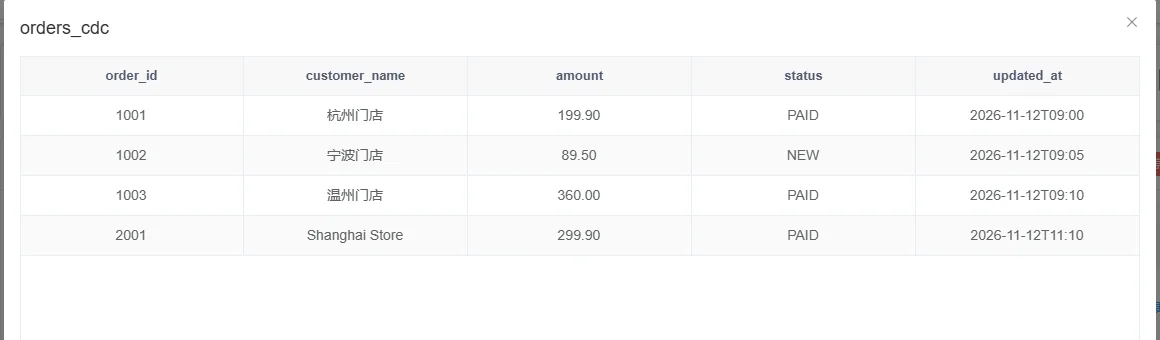
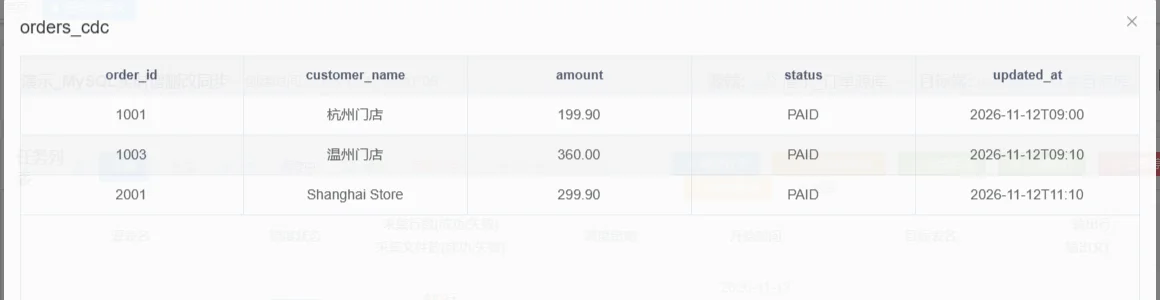
目标仍是同一条 2001,金额变为 299.90,状态变为 PAID,时间也更新。这一步与刚才按 order_id 的普通字段增量有明显区别:主键不变,CDC 仍然能采集更新事件。
删除订单:目标不再保留 1002
删除一条初始订单:
DELETE FROM dm_demo_source.orders_cdc
WHERE order_id = 1002;
目标库中的 1002 也被删除。此时剩下 1001、1003、2001 三条,源目标按主键排序后,五个字段逐行比较一致。
正常停止后再启动,能接着同步吗?
本次还走了一次正常停止后的恢复流程:
- 点击实时任务“全部停止”,确认任务停止。
- 在源库新增订单 2002,此时目标查询仍只有之前的三条。
- 直接“全部启动”原任务,不重置,也不重新填写 offset。
- 目标库补入 2002,已有记录保持,最终与源表逐行一致。
停止期间执行的 SQL 是:
INSERT INTO dm_demo_source.orders_cdc VALUES
(2002, 'Suzhou Store', 168.00, 'PAID', '2026-11-12 11:20:00');
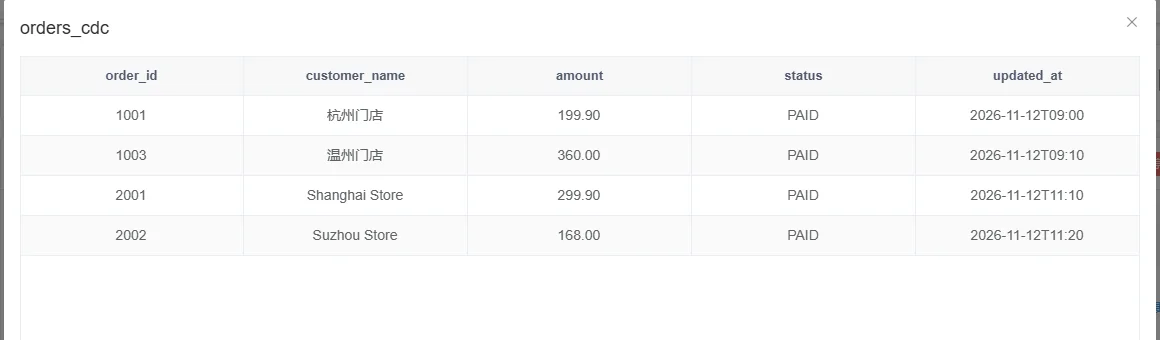
恢复使用任务保存的位点,源库还需要保留对应的 binlog。“停止”和“重置”是不同操作,日常暂停后希望续传时,不要把重置当成启动前的必需步骤。本次验证的是正常停止与重新启动流程。
最终验证结果如下:
| 验证动作 | 目标端观察结果 |
|---|---|
| 普通一次性全量 | 初始 3 条订单完整到达,采集和输出均无失败 |
| 普通 ID 增量 | 保留历史记录,补入 1004,目标共 4 条 |
| CDC 首次快照 | 初始 3 条订单到达,任务继续监听 |
| CDC 新增 | 2001 写入,金额 268.80、状态 NEW |
| CDC 更新 | 同一 2001 改为 299.90、PAID |
| CDC 删除 | 1002 从目标移除 |
| CDC 停止后恢复 | 补入停机期间的 2002,源目标最终 4 条逐行一致 |
如果需求是搬一遍现有数据,可以先配置普通全量;只需定期补充新增记录,可以选择合适的增量字段;需要持续保持新增、修改和删除,则按源端条件配置 CDC。用自己的小表走通配置、字段映射和结果核对,再逐步扩大范围。
可以从 官网下载永久免费社区版 开始,用 任务管理文档 对照界面操作;更换目的端前,再查看 数据源读写与 CDC 支持范围。